详细介绍
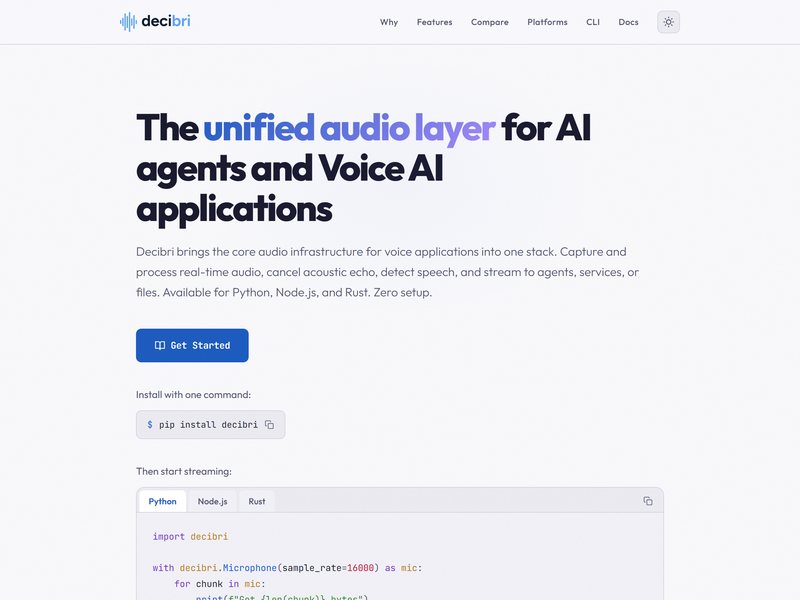
做语音应用的人都知道,模型之外最磨人的是音频这一层:麦克风怎么采、扬声器怎么放、回声怎么消、什么时候算用户开口说话。Decibri 把这些收进了一个库。
它提供实时麦克风采集、扬声器输出、声学回声消除和语音活动检测,采到的音频可以流式送给智能体、云服务或者写进文件。Python、Node.js、Rust 三种语言用的是同一套接口。
上手成本很低。Python 下一条 pip install decibri 装好,几行代码就能开始从麦克风读数据,不需要另外配系统依赖。
这是纯粹的开发者基础设施,没有界面,也不含语音识别或合成模型,那些要你自己接。正在搭语音智能体、被各平台音频接口折腾过的开发者会用得上。
相关推荐
Sarv NC Lite
Sarv NS去除背景噪音以实现更清晰的通话。
Shanda Studio
一体化播客平台,简化编辑、托管和发布。
MMAudio
用于为视频生成高质量音频的人工智能工具。
VoiceChanger.im: AI Voice Cloner & Text to Speech Free Online
AI 语音转换器,用于通过效果转换声音,以便于内容创作和保护隐私。
Melodiez
Melodiez是一款由人工智能驱动的音乐和声音应用,旨在帮助您专注、放松、睡眠,并照顾您的家人,包括宠物和婴儿。
App & API Privacy Mgmt
用于检测和执行API隐私标准的人工智能平台,确保安全和合规的数据共享。